Controlar la máquina y generar bien
El píxel viene del modelo, pero la creatividad debería ser tuya. Y si vas a generar, que sea decente.
Crear para comprender
Imágenes y vídeos con IA, y claves para detectar lo sintético
Controlar la máquina y generar bien.
El píxel viene del modelo, pero la creatividad debería ser tuya.
¿Real o IA?
Idea claveA ojo, ya no sabemos distinguir. Y eso no es culpa nuestra.
Hace dos años bastaba con contar dedos. Las imágenes generadas tenían manos de seis dedos, letreros con letras inventadas y una piel demasiado lisa. Si sabías dónde mirar, las pillabas.
Antes de seguir leyendo, prueba. Aquí tienes ocho imágenes: unas son fotos reales y otras están generadas. Decide qué es cada una y después mira la solución.
Si has acertado más o menos la mitad, estás en la media. Lo esperable es acertar entre un 50 y un 60 %, que es poco más que tirar una moneda. No es culpa tuya: los modelos de 2026 ya no cometen los errores que nos enseñaron a buscar, y alguna foto real parece más falsa que las generadas.
Por eso este taller va en dos tiempos. Primero las fabricamos, para entender cómo se hacen, qué saben hacer y dónde fallan. Después del descanso aprendemos a cazarlas con métodos que no dependen del ojo.
Hace dos años bastaba con contar dedos.
Vamos a ver si sigue siendo así.
¿Real o IA?
A ojo, ya no sabemos distinguir. Y no es culpa nuestra.
Primero las fabricamos. Después del descanso, las cazamos.
Cómo crea una IA una imagen
Idea claveLa IA ha aprendido patrones de millones de fotos y los recompone desde ruido. Es muy buena en lo típico y mala en lo original: lo original lo tienes que poner tú.
La IA generativa es la rama de la inteligencia artificial que produce contenido nuevo: texto, imágenes, música o vídeo. No copia una imagen de una base de datos. Ha visto tantos ejemplos que ha aprendido cómo suelen ser las cosas, y con eso fabrica algo que no existía.
Aprender: de la foto al ruido
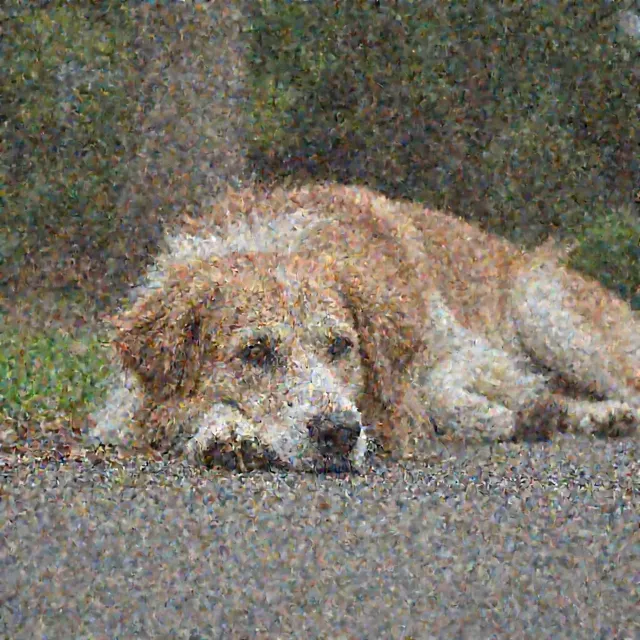
Para entrenar un modelo de imágenes se reúnen millones de pares de imagen y descripción ("un perro marrón sentado en la hierba"). Después se ensucia cada imagen poco a poco con ruido, como la nieve de una televisión mal sintonizada, hasta que no queda nada reconocible. El modelo aprende a hacer el camino contrario: mirando una imagen con ruido y su descripción, adivina qué ruido sobra y lo quita.
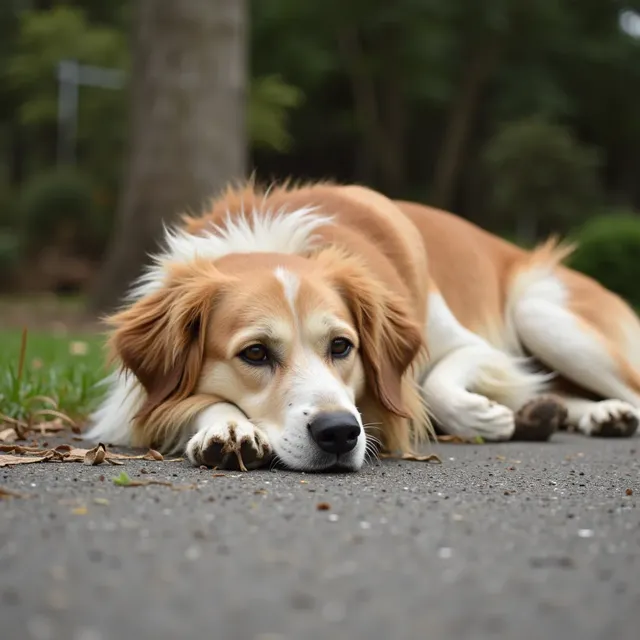
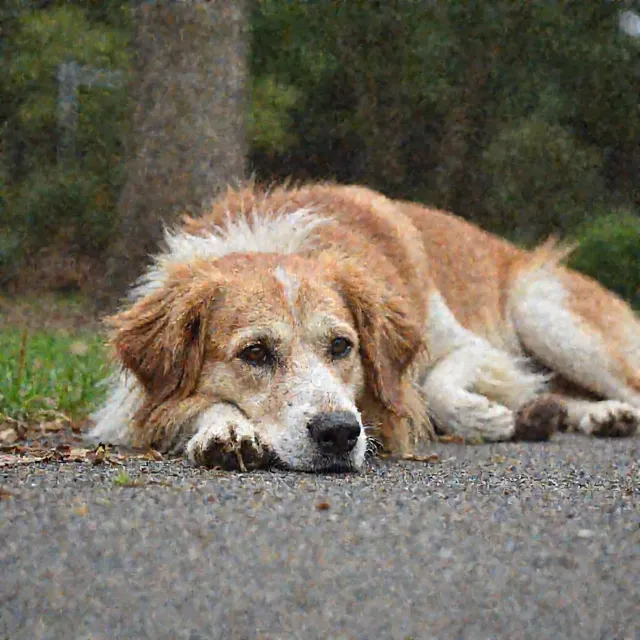
Crear: del ruido a la foto
Cuando le pides una imagen, el modelo parte de ruido aleatorio y repite lo que aprendió: quita un poco de ruido, guiado por tu texto (el prompt), y vuelve a empezar. En unas decenas de pasos aparece una imagen que encaja con la descripción.
Qué significa esto en la práctica
- Tiende a lo más frecuente. Caras guapas, luz de anuncio, composición centrada. Si no le das dirección, todo sale "medio", porque lo medio es lo que más ha visto.
- Lo que pones en el prompt tiende a aparecer, literal. Si nombras cinco cosas, dibuja cinco cosas, aunque no quepan.
- Cada generación es una tirada distinta. El ruido de partida cambia cada vez, así que el mismo prompt da imágenes diferentes.
Compruébalo
Usa la caja de abajo para lanzar el mismo prompt dos veces y comparar. Luego escríbelo en inglés. En 2025 la diferencia entre idiomas era clara, como muestran estos dos gatos; con los modelos de 2026 es mucho menor, pero mejor verlo que creerlo.
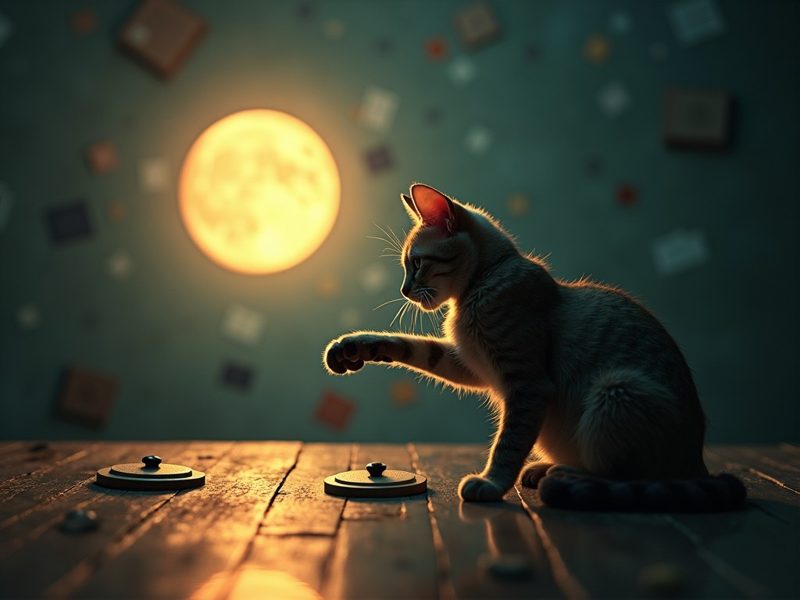
ES · "Un gato jugando al ajedrez bajo la luz de la luna"
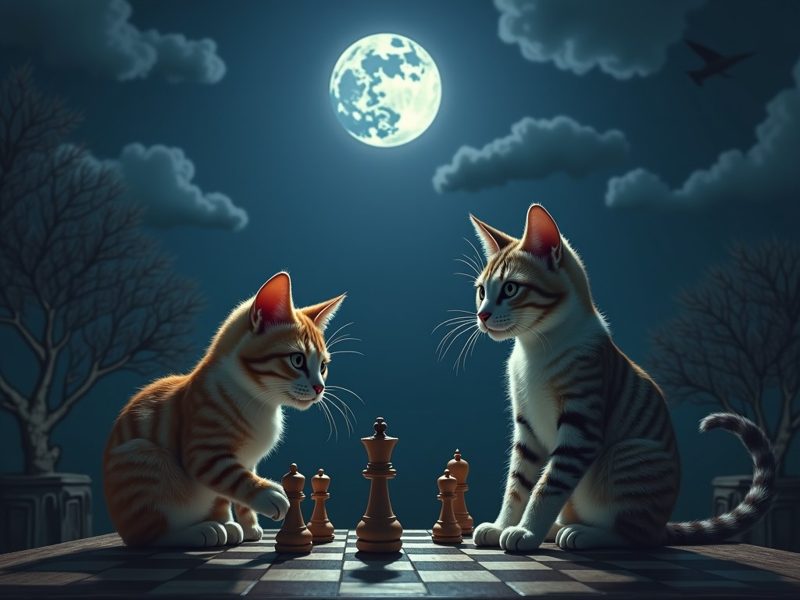
EN · "A cat playing chess under moonlight"
Un apunte más: a un modelo se le puede enseñar una cara o un estilo concretos con unas pocas fotos (es lo que se llama LoRA). Lo retomaremos al hablar de deepfakes.
Ha visto millones de fotos con su descripción.
No copia: aprende cómo suelen ser las cosas y fabrica algo nuevo.
Aprender: de la foto al ruido
Crear: del ruido a la foto
Guiada por el prompt, paso a paso.
Consecuencias
- Tiende a lo más frecuente. Sin dirección, todo sale "medio".
- Lo que nombras aparece, literal.
- Cada generación es una tirada distinta.
Mismo prompt, dos tiradas
Práctica 1: dominar el prompt
Idea claveControlar la máquina es dar dirección e iterar, no escribir más palabras.
En 2025 recomendábamos escribir prompts "escopeta": listas de palabras clave separadas por comas. Los modelos actuales entienden mejor frases descriptivas, como las que usarías para explicarle una foto a alguien por teléfono. Tres consejos:
- Describe en frases: quién, qué, dónde, con qué luz, en qué plano y con qué estilo.
- Pide menos elementos y más intención. Una cosa bien elegida vale más que cinco amontonadas.
- Si algo no sale, edita la imagen en vez de empezar de cero.
Reto A · De vago a dirigido
6 min · 3 imágenesEmpieza con "Un gato en la luna". Después elige la luz y el plano (por ejemplo, "contraluz del amanecer terrestre, plano general desde el suelo lunar"). Por último, añade un estilo concreto ("fotografía de la NASA de 1969", "grabado japonés", "plastilina").
Qué se descubre: la dirección cambia más la imagen que el número de palabras.
Reto B · Retocar
6 min · 3 imágenesParte de una imagen tuya (generada en el reto A o una foto que subas) y pide cambios concretos: cambia el cielo, quita un objeto, añade un texto corto.
Qué se descubre: editar es más preciso que regenerar. Y también es la base de muchos bulos: no hace falta inventar una foto entera, basta con retocar una real.
Cuando tengas tu mejor retoque, ábrelo en el historial y pulsa Compartir con la clase. Aparecerá en la pestaña "Clase" de todo el mundo.
Cómo dar dirección
- Frases, no listas: quién, qué, dónde, luz, plano, estilo.
- Menos elementos, más intención.
- Si no sale, edita en vez de empezar de cero.
De vago a dirigido
"Un gato en la luna" → + luz y plano → + estilo.
Retocar
Cambia el cielo, quita un objeto, añade un texto. Comparte el mejor en "Clase".
El slop: contenido basura en la calle
Idea claveGenerar sin criterio produce basura visible, y la gente lo nota. Si vas a generar, que sea decente.
Se llama slop al contenido generado en masa, sin revisión ni intención, que se publica porque hacerlo es gratis. Ya no está solo en las redes: está en los carteles de las farolas, en los menús de los bares y en los folletos que te dan por la calle.
Fotografiados en Navarra en septiembre y octubre de 2026. Pulsa uno para verlo en grande.
Delante de cada uno, hazte tres preguntas:
- ¿Qué delata que es IA? Texto deformado, logotipos inventados, ese estilo genérico "de IA", detalles sin sentido.
- ¿Qué te transmite de quien lo ha hecho? Prisa, poco cuidado, poca confianza.
- ¿Comunica lo que tiene que comunicar? Qué es, cuándo y dónde.
Cuatro patrones del slop
John Hartnup los describe al contar cómo diseñó sus prompts de pósters (artículo):
- Todo lo que nombras aparece. Una fiesta en un campo de críquet acaba con críquet, iglesia, carpas y todas las atracciones a la vez.
- Relleno. El modelo tiende a ocupar cada hueco.
- Literalidad. Un grupo llamado "Carver and the Flood" acaba ilustrado con herramientas de carpintería y agua.
- Logotipos inventados. Escudos y marcas que no existen.
El problema no es la IA, es publicar sin mirar. El píxel lo pone el modelo; la idea, la selección y la revisión las pones tú.
Slop: generado en masa, sin revisión ni intención.
Se publica porque es gratis hacerlo.
Visto en la calle
Patrones del slop
- Todo lo que nombras aparece.
- Relleno: ocupa cada hueco.
- Literalidad: "Carver and the Flood" → serruchos y agua.
- Logotipos inventados.
El problema no es la IA, es publicar sin mirar.
ABC del diseño gráfico para no diseñadores
Idea claveCon cinco reglas básicas puedes saber si un póster funciona y pedirle a la IA lo que le falta.
Antes de abrir la herramienta, ten una imagen mental: un objetivo claro de lo que quieres conseguir, y usa la IA solo para llevarlo a la realidad. Pelearte con ella hasta que haga lo que tienes en la cabeza puede ser más frustrante que aceptar lo primero que salga, pero el resultado es mucho más humano.
No hace falta saber diseñar para notar que un cartel no funciona. Estas cinco reglas explican casi siempre por qué. Cada una viene con un ejemplo que funciona y otro que no.
1 · Contraste
Texto oscuro sobre fondo claro, o al revés, y tamaños muy distintos entre el título y los detalles. Si se lee desde cinco metros, funciona.
2 · O iguales o diferentes, nunca parecidos
Dos tipografías casi iguales, dos tamaños casi iguales o dos colores casi iguales parecen un error. Si algo es distinto, que se note mucho.
3 · Espacio negativo
El vacío no es desperdicio: es lo que deja respirar al mensaje. Lo contrario del relleno del slop.
4 · Jerarquía
Una sola cosa manda (el título o la imagen); luego qué, cuándo y dónde. Si todo grita, no se oye nada.
5 · Alineación y pocos elementos
Todo alineado a algo. Mejor una imagen potente que cinco pequeñas.
Truco práctico: entrecierra los ojos delante del póster. Lo que sigues viendo es lo que manda. Si no ves nada, o lo ves todo a la vez, falta jerarquía.
Reto · Arregla un cartel de la calle
Elige uno de los carteles del bloque 4 y pásaselo al modelo como imagen de partida. Pídele que lo rehaga aplicando las cinco reglas, pero sin perder la información: qué es, cuándo y dónde. Después compara: ¿qué ha quitado?, ¿qué manda ahora?, ¿se lee desde lejos? Si el resultado no te convence, no repitas la tirada sin más: di qué regla falla y pide solo ese cambio.
Ten una imagen mental. La IA solo la lleva a la realidad.
Cuesta más controlarla, pero el resultado es mucho más humano.
Cinco reglas para saber si un póster funciona.
1 · Contraste
Si se lee desde cinco metros, funciona.
2 · Iguales o diferentes
Nunca parecidos: lo casi igual parece un error.
3 · Espacio negativo
El vacío deja respirar al mensaje.
4 · Jerarquía
Si todo grita, no se oye nada.
5 · Alineación
Todo alineado a algo. Una imagen potente mejor que cinco pequeñas.
Arregla un cartel de la calle
Elige uno de los carteles malos y rehazlo con las cinco reglas.
Si falla, di qué regla y pide solo ese cambio.
Práctica 2: un póster decente
Idea claveLa idea es tuya y la IA ejecuta. Un buen póster sale de elegir qué dejar fuera.
- Elige un evento, real o inventado: un concierto, las fiestas del barrio, una charla, un mercadillo.
- Antes de escribir, piensa dos cosas: ¿cuál es la única imagen que lo resume? ¿Qué tres datos tiene que llevar?
- Parte de un estilo con historia. John Hartnup ha publicado cien prompts de pósters inspirados en movimientos gráficos (Poster prompts). Sus prompts son muy largos, así que en la caja tienes versiones resumidas de algunos estilos como punto de partida. Elige uno y adáptalo a tu evento.
- Sigue los consejos del propio autor: pocas atracciones dan mejor póster, pide que no invente logotipos y repite la tirada dos o tres veces.
- Revisa el resultado con las cinco reglas del bloque anterior y una pregunta más: ¿lo colgaría con mi nombre?
Comparte en "Clase" el que más te guste. En la pantalla comentaremos tres o cuatro: uno que funcione y por qué, y uno que caiga en el slop y qué le falta.
Cuidado con el texto. Los modelos frontera, como Nano Banana y GPT Image, ya escriben bien el texto de un póster. Aun así, conviene pedir el menor texto posible y revisarlo letra a letra: una errata o una fecha cambiada delatan el póster enseguida. Si el modelo que usas falla, haz como recomienda el propio Hartnup: genera la imagen sin texto y añádelo después con una herramienta como Canva.
La idea es tuya. La IA ejecuta.
Un buen póster sale de elegir qué dejar fuera.
Antes de escribir
- ¿Cuál es la única imagen que lo resume?
- ¿Qué tres datos tiene que llevar?
- ¿De qué estilo gráfico partes?
Un póster decente
- Pocas atracciones.
- Sin logotipos inventados.
- Repite la tirada 2 o 3 veces.
Revisa antes de compartir
- Contraste · iguales o diferentes · espacio · jerarquía · alineación
- ¿Lo colgaría con mi nombre?
Descanso.
Al volver, toca cazarlas.
Reconocer e identificar
Reconocer e identificar.
La física delata: líneas, reflejos y sombras
Idea claveLa IA imita cómo se ven las fotos, pero no calcula la geometría de la luz. Con una regla se pueden pillar fallos que el ojo no ve.
Las pistas clásicas ya no sirven. Manos, pies, texto sin sentido o la falta de grano están casi resueltos en los modelos nuevos (TechSpot, mayo de 2026). Lo que todavía falla es la geometría: el modelo ha aprendido cómo parece una foto, pero no ha calculado dónde caen la luz y las sombras.
Hany Farid, experto en análisis forense digital de la Universidad de California en Berkeley, propone tres comprobaciones que puedes hacer con una regla o con el editor de fotos del móvil:
En el ejemplo del artículo de TechSpot, unos soldados posan en un pasillo cuyas baldosas no convergen en un único punto. Mirando de cerca aparecen también los fallos de siempre: texto deformado y cadenas que no llevan a ninguna parte. Los errores clásicos a veces siguen ahí, escondidos en los detalles.
Ejercicio por parejas · 6 min
Con dos o tres imágenes del quiz inicial y alguna de la pestaña "Clase", trazad las líneas y decidid: ¿real o generada?
- Para trazar las líneas sin instalar nada: Vanishing Point Finder. Subes la imagen y dibujas encima las líneas de fuga. También vale el editor de fotos del móvil o una copia impresa.
- Para más ejemplos sin gastar generaciones: los benchmarks de imagen de OpenRouter. Ahí se ve el mismo prompt resuelto por muchos modelos, y las imágenes se pueden descargar.
Tres reglas simples para identificar errores típicos.
1 · Puntos de fuga
Las paralelas reales convergen en un solo punto.
2 · Reflejos
Objeto y reflejo, unidos por líneas paralelas.
3 · Sombras
Las líneas de sombra se cruzan en la fuente de luz.
Trazad las líneas
Imágenes del quiz y de "Clase". ¿Real o generada?
Herramientas oficiales y procedencia
Idea claveLas grandes empresas marcan lo que generan y ofrecen verificadores. Un "sí" es fiable; un "no encontrado" no demuestra nada.
Las grandes tecnológicas dejan dos tipos de huella en lo que generan sus modelos:
- Credenciales de contenido (C2PA): una etiqueta pegada al archivo que dice quién lo hizo y con qué. Se puede arrancar: una captura de pantalla o subirlo a muchas redes la borra.
- Marca de agua invisible (SynthID): va dentro de los propios píxeles y suele sobrevivir a recortes, cambios de tamaño y compresión.
| Herramienta | Qué comprueba | Cómo se usa | Límite principal |
|---|---|---|---|
| Verificador de OpenAI openai.com/verify · en prueba desde mayo de 2026 | Credenciales C2PA y la marca SynthID de imágenes de ChatGPT, Codex y su API; audio desde julio de 2026 | Subir la imagen | Solo reconoce contenido de OpenAI. Si no encuentra marca, no concluye nada |
| Gemini con SynthID | Marca SynthID de los modelos de Google en imagen, vídeo y audio, y credenciales C2PA | En gemini.google.com, adjuntar el archivo y preguntar "¿Está generado con IA?" | Solo IA de Google. Unas 10 comprobaciones por tipo cada 24 h; vídeos de menos de 90 s |
| Content Credentials Verify contentcredentials.org/verify | Metadatos C2PA de cualquier herramienta que los añada (Adobe, OpenAI, Google y otras) | Subir la imagen | Los metadatos se pierden con una captura o al subirla a muchas redes |
| Búsqueda inversa Google Lens, TinEye | Si la imagen ya existía, dónde y desde cuándo | Subir o pegar la imagen | No dice si es IA, solo su historia |
Pruébalo
Sube a Gemini una imagen generada con un modelo de Google, después una captura de pantalla de esa misma imagen y, por último, una foto real. Compara las tres respuestas.
Las imágenes que generéis en el taller con modelos de Google llevan su SynthID, así que podéis probarlo con las vuestras.
Lo que queda fuera: los modelos abiertos que se ejecutan en un ordenador propio no marcan nada. La ausencia de marca no exculpa a una imagen.
Esto pesa sobre todo en los casos más graves, como los deepfakes pornográficos. Los grandes modelos comerciales están "censurados" y se niegan a generar ese contenido, así que las herramientas que lo fabrican recurren precisamente a modelos abiertos, que no dejan ninguna marca. Justo donde más falta haría un verificador, no lo hay.
Un "sí" es fiable. Un "no encontrado" no demuestra nada.
Etiqueta o marca de agua
Etiqueta pegada al archivo. Una captura la arranca.
Dentro de los píxeles. Sobrevive a recortes y compresión.
Verificadores
Gemini, tres veces
- Imagen generada con Google
- Captura de pantalla de esa imagen
- Foto real
Los modelos abiertos no marcan nada.
Los deepfakes pornográficos salen de modelos abiertos.
Los comerciales se niegan a hacerlos. Los abiertos no dejan marca.
Práctica 3: vídeo y sesgos
Idea claveAnimar una foto cuesta un clic. Y la IA tiene una idea por defecto de cómo es cada persona.
Vídeo desde cero
Los modelos de vídeo pueden partir solo de un texto, igual que los de imagen. Hoy en día ya producen vídeos de muy alta calidad, pero por lo general siguen siendo bastante reconocibles: todo es demasiado limpio, la luz es de anuncio, la cámara se mueve con una suavidad imposible y nada tiene la torpeza de lo grabado de verdad.
Partir de algo real
Lo difícil de detectar llega cuando el vídeo parte de una imagen real: una foto tuya, de tu calle o de alguien que conoces. El primer fotograma es auténtico, y el modelo solo tiene que continuar lo que ya existe. Ahí ya no hay un "estilo IA" que te avise.
Reto C · Dar vida a una imagen
9 min · 2 vídeosAnima tu póster o cualquier imagen tuya en un clip de 5 segundos. En el segundo intento pide un movimiento complejo: alguien que se gira, una mano que escribe.
Qué se descubre: la cámara y el ambiente salen bien; las manos, las caras y la física, peor. Busca en tu propio vídeo las pistas de detección.
En la caja puedes elegir entre tres modelos de vídeo baratos: HeyGen Video 1, Seedance 2.0 Mini (ByteDance) y Veo 3.1 Lite (Google). Prueba uno y, si te sobra un vídeo, compáralo con otro. Para ver qué hacen los modelos más caros con los mismos prompts, mira los benchmarks de vídeo de OpenRouter.
Mientras se generan (tardan de uno a tres minutos), busca estas pistas en lo que vayas viendo:
- Objetos que aparecen o desaparecen de un plano a otro.
- Física imposible: líquidos, telas o pelo que no se mueven como deberían.
- Clips de 5 a 10 segundos sin ningún corte.
- Imagen de baja calidad, como de cámara de seguridad, usada como disfraz.
Reto D · ¿Quién es?
6 min · 4 imágenesGenera "a nurse", "a doctor", "a CEO" y "a cleaner", sin más detalles, y comparte las cuatro en "Clase".
Qué se descubre: con 25 personas haciendo lo mismo a la vez, el patrón de género, edad y origen salta a la vista en la pestaña "Clase". La IA aprende de internet, e internet refleja los sesgos de la sociedad. Puedes contrarrestarlo siendo específico en el prompt.
Vídeo desde cero
Muy alta calidad, pero todavía reconocible: demasiado limpio, luz de anuncio, cámara imposible.
Nothing is real
Lo difícil es cuando parte de una imagen real.
El primer fotograma es auténtico; el modelo solo continúa lo que ya existe.
Dar vida a una imagen
5 s. En el segundo intento, un movimiento complejo.
HeyGen Video 1 · Seedance 2.0 Mini · Veo 3.1 Lite
Pistas de vídeo
- Objetos que aparecen o desaparecen
- Física imposible
- 5 a 10 s sin cortes
- Baja calidad como disfraz
¿Quién es?
A nurse · a doctor · a CEO · a cleaner. Sin más detalles. Compartid todo.
Usar la IA con criterio
Idea claveLa pregunta no es solo "cómo", sino también "si" y "cuándo". Y decirlo cuando se usa.
Deepfakes que tuvieron consecuencias
- Explosión falsa en el Pentágono (mayo de 2023). Una imagen generada que circuló en redes provocó una caída momentánea de la bolsa estadounidense.
- Videollamada falsa en Arup (Hong Kong, 2024). Un empleado transfirió unos 25 millones de dólares tras una reunión por vídeo en la que el director financiero y sus colegas eran deepfakes.
- Taylor Swift (enero de 2024). Imágenes sexuales generadas sin su consentimiento acumularon millones de visualizaciones antes de ser retiradas.
- Fideuram, Intesa Sanpaolo (Italia, febrero de 2026). Suplantando por WhatsApp y por teléfono al consejero delegado del grupo y a un abogado, con la voz clonada por IA, los estafadores consiguieron que la banca privada hiciera 11 transferencias por casi 95 millones de euros. La Fiscalía de Milán lo investiga y una parte del dinero sigue sin recuperarse (FinTelegram).
- Los deepfakes sexuales de Grok (2025–2026). En plena Navidad, el chatbot de X llegó a publicar hasta 6.000 imágenes sexuales generadas por hora a petición de sus usuarios. La policía de Gales del Sur acaba de reabrir el caso de una de las víctimas, Jess Davies, que se había cerrado en mayo por no identificar al autor, y ahora lo investiga como delito sexual (The Bureau of Investigative Journalism, 22 de octubre de 2026).
Derechos y etiquetado
¿De quién es una imagen generada? Si nadie la ha trabajado, de nadie. En EE. UU., el Tribunal Supremo se negó en marzo de 2026 a revisar el caso Thaler, así que queda firme que sin autor humano no hay derechos de autor (Mayer Brown). La Oficina de Copyright estadounidense añade que escribir el prompt no basta: hace falta una aportación humana que se note en el resultado, como seleccionar, retocar o componer. En Europa el criterio es parecido, porque la obra tiene que ser creación intelectual de una persona.
¿Se puede entrenar con obras ajenas? Los tribunales todavía no se ponen de acuerdo. Disney, Universal y Warner Bros. demandaron a Midjourney en 2025 por generar a sus personajes, y el juicio sigue sin fecha (AI Lawsuit Tracker). En Múnich, la sociedad de autores alemana GEMA ganó a OpenAI en noviembre de 2025 y a Suno en julio de 2026, aunque las dos sentencias están recurridas o pueden recurrirse (Reed Smith). En Reino Unido, en cambio, Getty Images perdió contra Stability AI y ha recurrido. El Tribunal de Justicia de la UE estudia su primer caso, Like Company contra Google, y su sentencia marcará el criterio europeo.
¿Hay que avisar? Sí. Desde el 2 de agosto de 2026, el Reglamento europeo de IA obliga a avisar cuando se publica un deepfake, y antes del 2 de diciembre de 2026 los generadores ya existentes deben marcar sus imágenes, audios y vídeos de forma que una máquina pueda detectarlo (ActuIA). La ley española que iba a fijar las sanciones decayó sin aprobarse al disolverse las Cortes el 6 de octubre, así que tendrá que volver a tramitarse.
Y una buena noticia: el Mickey de Steamboat Willie (1928) es de dominio público desde 2024.
Rutina de verificación en cuatro preguntas
Para cuando algo te llegue por redes y dudes. Hazle una foto y llévala encima.
- ¿Quién lo publica y de dónde lo ha sacado?
- ¿Lo cuentan otras fuentes fiables? ¿Qué dice la búsqueda inversa?
- ¿Qué dicen los verificadores oficiales y la física (líneas, reflejos, sombras)?
- ¿Me está provocando una emoción fuerte para que lo comparta ya?
Un dilema para terminar
¿Está bien que la asociación del barrio haga con IA el cartel de sus fiestas?
Deepfakes con consecuencias
- Pentágono, 2023: cae la bolsa
- Arup, 2024: 25 M$ por videollamada
- Taylor Swift, 2024: imágenes sin consentimiento
- Fideuram, 2026: 95 M€ con voces clonadas
- Grok, 2026: 6.000 imágenes sexuales por hora; caso reabierto
Derechos y etiquetado
- Sin autor humano, no hay derechos (EE. UU., 2026)
- Entrenar con obras ajenas: Midjourney, GEMA, Getty… sin resolver
- UE: avisar de los deepfakes desde agosto de 2026
- Steamboat Willie, dominio público
Antes de compartir
¿Está bien hacer con IA el cartel de las fiestas del barrio?
Quiz revancha y cierre
Idea claveAhora tengo método, aunque a ojo siga fallando.
Ocho imágenes nuevas, con una opción más: "No lo puedo saber sin más contexto". Mezclan fotos reales con imágenes de la clase.
Compara con tu resultado del principio. Si no has mejorado mucho, mejor: confirma que la verificación va por la física y el origen, no por la intuición. Y elegir "no lo puedo saber" también es una buena respuesta.
El píxel viene del modelo; la creatividad, el criterio y la responsabilidad son tuyos.
Revancha
Si no has mejorado mucho, mejor.
La verificación va por la física y el origen, no por la intuición.
El píxel viene del modelo; la creatividad, el criterio y la responsabilidad son tuyos.
Gracias · iris.dominguez@unavarra.es
Fuentes
- Poster prompts y Poster prompts v2, John Hartnup (20/09/2026)
- AI images are getting harder to spot, but physics gives them away, TechSpot (07/05/2026)
- Advancing content provenance, OpenAI (19/05/2026, actualizado en julio y octubre de 2026)
- Verificar contenido generado con IA en Gemini, ayuda de Google
- Content Credentials Verify, Content Authenticity Initiative
- Fotos reales de los quiz (Wikimedia Commons):
Crear para comprender · Semana de la IA 2026 · Cátedra Tracasa–UPNA